2027학년도 수능 문제를 국내외 주요 AI 모델에 풀게 한 결과, 중국 문샷AI의 모델이 450점 만점에 438점을 기록했다. 알리바바와 딥시크의 AI도 430점대를 받았다. 국산 AI인 업스테이지는 종합 점수에서 중국 모델에 뒤졌지만 수학에서는 97점을 받아 경쟁력을 보여줬다.
무료 이용이 가능한 AI 모델들도 높은 성적을 거뒀지만, 최상위 유료 모델과는 차이가 있었다. 오픈AI와 구글의 최상위 모델은 나란히 450점 만점을 기록했다. 무료 모델 중 가장 높은 점수를 받은 문샷AI와는 12점 차이다.
20일 순천향대학교 컴퓨터소프트웨어공학과 구유겸 씨가 공개한 ‘2027학년도 수능 거대언어모델(LLM) 풀이 대시보드’에 나타난 결과다. 이번 비교에서는 무료 이용이 가능한 중국 AI 4개 모델과 국산 AI 1개 모델의 성적을 살펴봤다.
평가에 사용된 450점은 국어 100점, 수학 100점, 영어 100점, 한국사 50점, 탐구 2과목 각 50점 등 6개 과목의 만점을 합산한 점수다. 각 모델의 최종 점수는 공통·선택과목과 탐구영역의 반영 비중 등을 고려해 환산한 결과다.
|
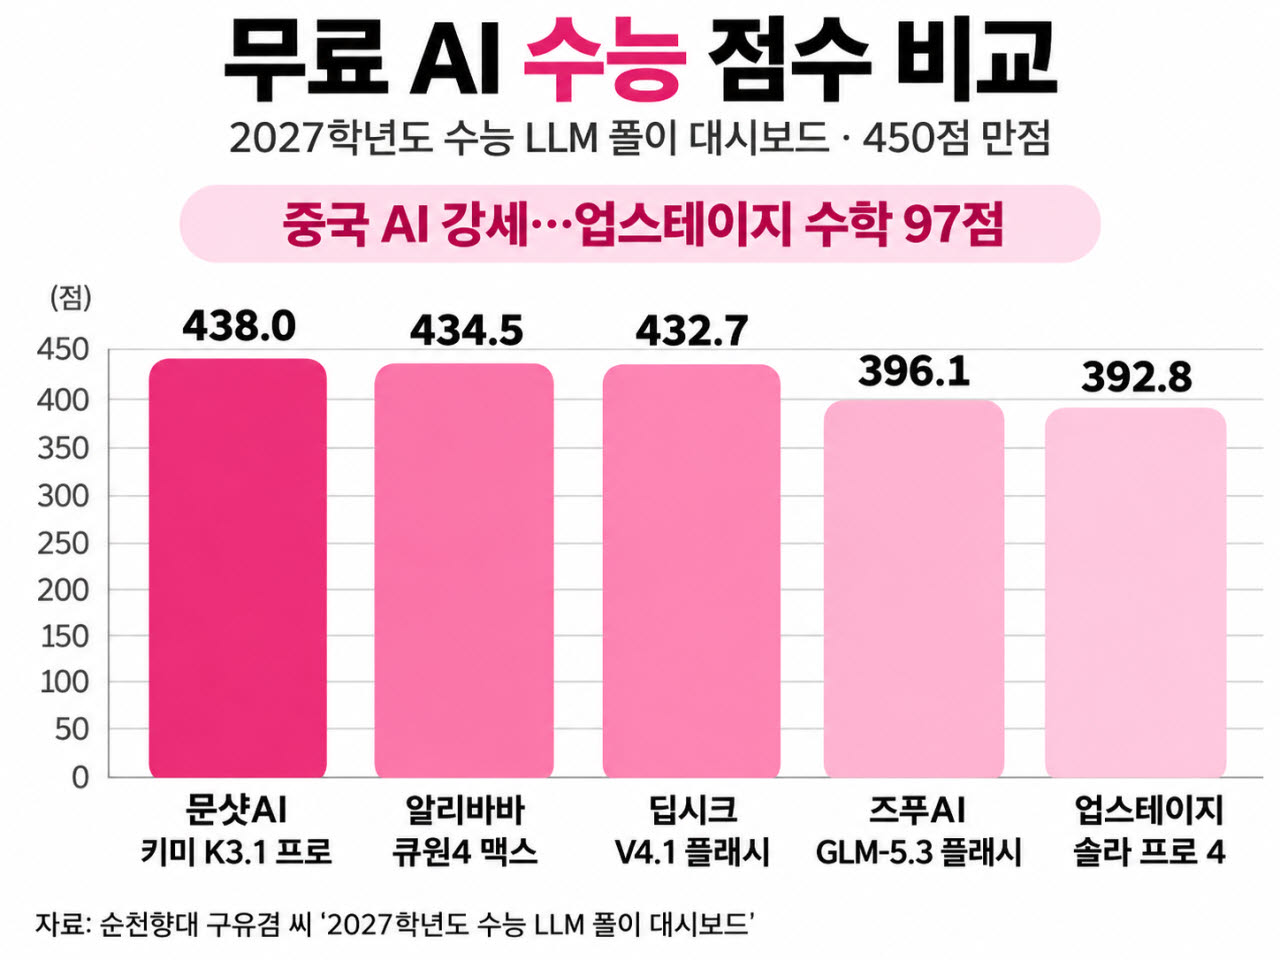
무료 이용 가능 모델 가운데 가장 높은 점수를 받은 AI는 중국 문샷AI의 ‘키미 K3.1 프로(Kimi K3.1 Pro)’였다. 총점 438점으로 만점까지 12점이 부족했다.
키미는 국어 100점, 수학 96점, 영어 100점, 한국사 50점, 탐구 92점을 기록했다. 국어와 영어, 한국사에서 만점을 받았고 탐구에서도 높은 성적을 냈다.
중국 알리바바의 ‘큐원4 맥스(Qwen4 Max)’는 434.5점으로 뒤를 이었다. 국어 100점, 수학 96점, 영어 100점, 한국사 50점, 탐구 88.5점이었다.
두 모델은 국어·수학·영어·한국사 점수가 같았다. 총점 3.5점 차이는 탐구 영역에서 발생했다.
중국 딥시크의 ‘딥시크 V4.1 플래시(DeepSeek V4.1 Flash)’는 432.7점을 기록했다. 국어 95점, 수학 98.7점, 영어 100점, 한국사 50점, 탐구 89.1점을 받았다.
특히 수학에서는 딥시크가 앞섰다. 98.7점으로 이번에 비교한 무료 모델 5개 중 최고점을 기록했다. 키미와 큐원4 맥스보다 2.7점 높았다.
중국 상위 3개 모델은 모두 영어와 한국사에서 만점을 받았다. 키미와 큐원4 맥스는 국어에서도 100점을 기록했다. 중국 기업이 개발한 AI가 한국어 독해와 수학 문제에서도 높은 성적을 거뒀다는 점이 눈에 띈다.
국산 업스테이지 수학 97점…탐구에서는 격차
국산 AI인 업스테이지의 ‘솔라 프로 4(Solar Pro 4)’는 총점 392.8점을 기록했다. 국어 90점, 수학 97점, 영어 88점, 한국사 50점, 탐구 67.8점이었다.
가장 눈에 띄는 과목은 수학이다. 솔라 프로 4는 97점으로 중국 키미와 큐원4 맥스(각 96점)를 1점 앞섰다. 최고점을 받은 딥시크(98.7점)와도 1.7점 차이에 불과했다.
한국사에서도 50점 만점을 받았다. 반면 국어와 영어에서는 중국 상위 모델보다 낮은 점수를 기록했다.
특히 탐구 영역의 차이가 컸다. 솔라 프로 4의 탐구 점수는 67.8점으로 키미(92점)보다 24.2점 낮았다. 큐원4 맥스(88.5점), 딥시크(89.1점)와 비교해도 20점 넘게 차이가 났다.
국산 AI가 수학에서는 중국 주요 모델과 대등한 성적을 냈지만, 탐구 영역에서는 개선 과제를 드러낸 것이다.
|
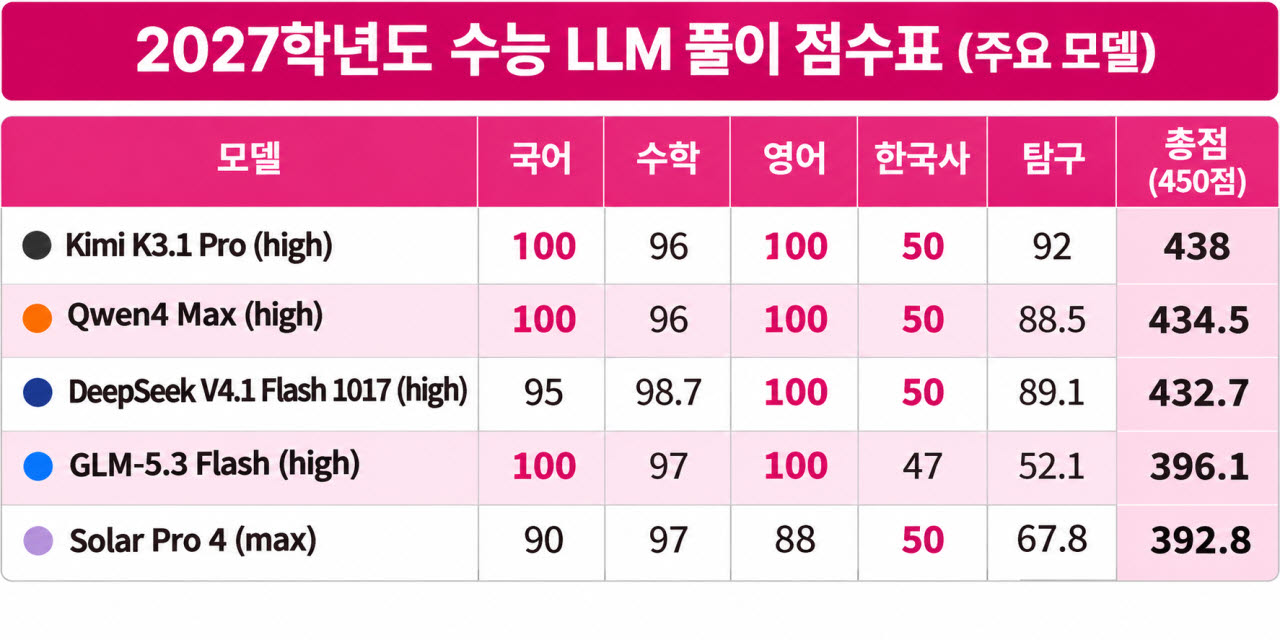
중국 즈푸AI의 ‘GLM-5.3 플래시(GLM-5.3 Flash)’는 총점 396.1점을 기록했다. 국어와 영어에서 각각 100점, 수학에서 97점을 받았다. 한국사도 47점으로 높은 편이었다. 그러나 탐구에서는 52.1점에 그쳤다.
국어·영어 만점에 수학 97점이라는 성적에도 총점은 400점을 넘지 못했다.
업스테이지와 비교해도 차이가 드러난다. GLM-5.3 플래시는 솔라 프로 4보다 국어에서 10점, 영어에서 12점 높았다. 반대로 탐구에서는 15.7점 낮았다. 두 모델의 총점 차이는 3.3점에 불과했다.
AI 모델마다 과목별 강점과 약점이 다르다는 의미다. 국어와 영어에서 만점을 받고 수학에서 높은 점수를 받더라도 탐구 영역에서는 다른 결과가 나타날 수 있다.
무료 AI 438점, 유료 모델은 만점…성능 격차
무료 AI도 높은 성적을 거뒀지만 최상위 유료 모델에는 미치지 못했다. 같은 대시보드에서 오픈AI의 ‘GPT-6.2 아스트라(Astra)’와 구글의 ‘제미나이 4 네온(Neon)’은 나란히 450점 만점을 기록했다. 오픈AI의 ‘GPT-6.2 솔(Sol)’은 449.6점, 앤스로픽의 ‘클로드 페이블 5.2’와 ‘클로드 오퍼스 5.5’는 각각 449.3점을 받았다.
무료 모델 중 최고점인 문샷AI 키미(438점)는 만점 모델보다 12점 낮았다. 알리바바(434.5점)는 15.5점, 딥시크(432.7점)는 17.3점, 국산 업스테이지(392.8점)는 57.2점 차이가 났다.
무료 채팅은 횟수 제한…API 이용은 별도 과금
이번 대시보드는 모델별 성적과 무료 이용 가능 여부도 보여준다. 일부 모델은 공식 웹사이트나 앱에서 무료로 이용할 수 있지만 메시지 횟수 등에 제한이 있다. 개발자가 프로그램에 연결하는 응용프로그램인터페이스(API)는 별도 요금이 부과되거나 제한적인 무료 한도가 적용된다.
이번 평가도 API로 진행됐다. 개발자인 구유겸 씨는 수능 문제 공개 직후 평가를 실시해 정답을 미리 학습했을 가능성을 줄였다고 설명했다. 인터넷 검색이나 계산기 등 외부 도구는 사용하지 않았으며, 그림과 그래프는 이미지로 제공했다.
AI가 수능에서 만점을 받는 시대지만, 누구나 같은 수준의 AI를 이용할 수 있는 것은 아니다. 과거에는 정보 접근성이 격차를 만들었다면, 앞으로는 어떤 AI를 활용하느냐가 학습과 업무 능력의 차이로 이어질 수 있다.
AI가 모두에게 기회를 넓혀주는 도구가 될지, 경제력에 따른 불평등을 키우는 새로운 장벽이 될지 고민과 대책이 절실한 시점이다.